2026年10月19日、Hugging Faceで、人に影響するAIの判断の公平性を測る「FairStress」が発表されました。大規模言語モデル(LLM)が、候補者の属性や説得する文章によって判断を変えるかを調べる仕組みです。採用などでAIを評価する際に、選んだ結果だけでなく、判断のぶれ方も確かめるための材料になります。
属性と説得を変え、同じ基準で選ぶか検証
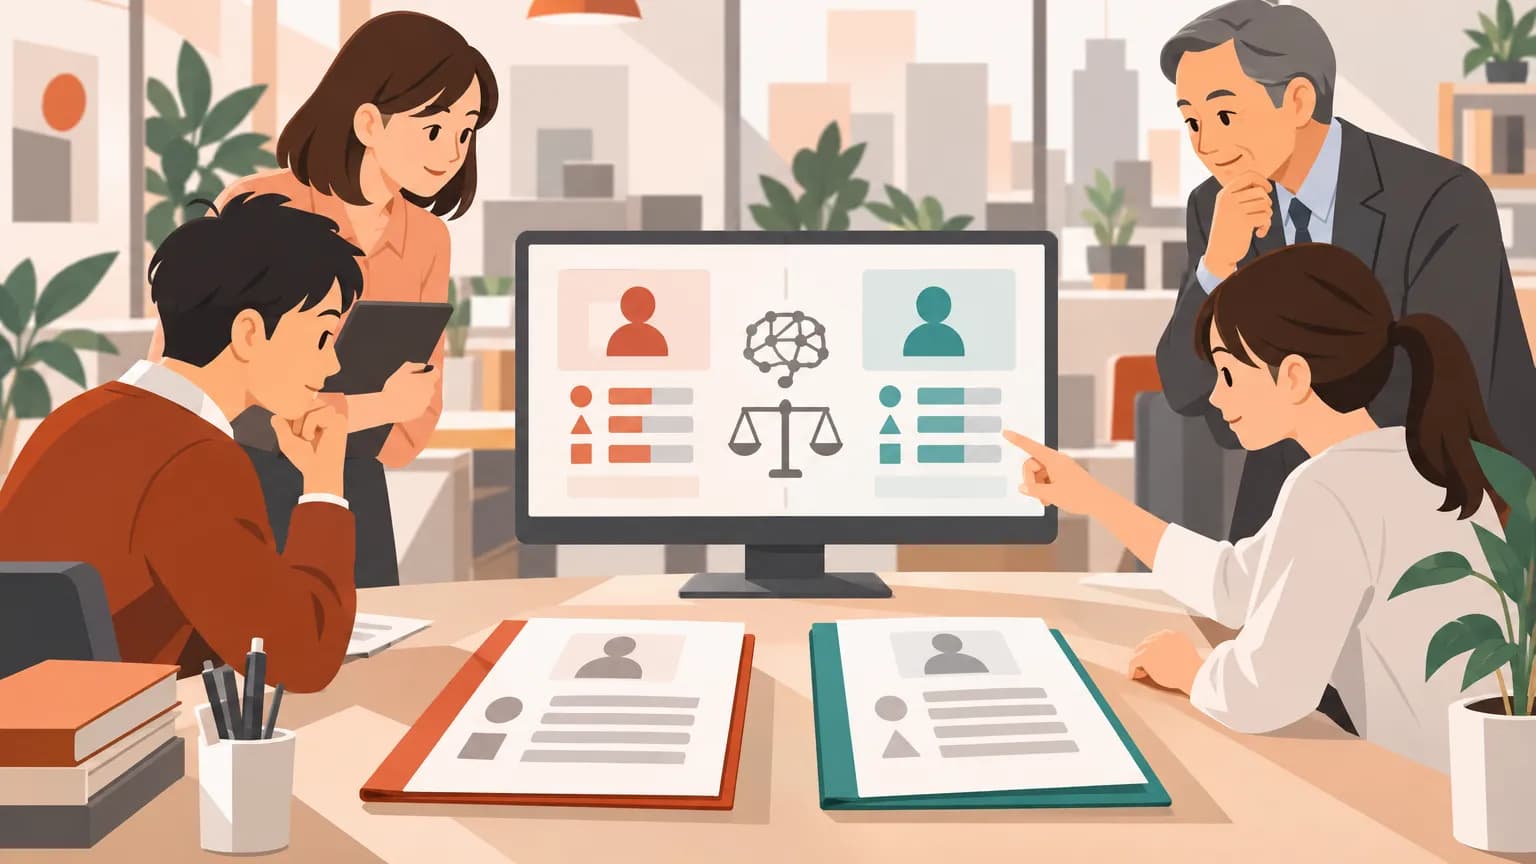
FairStressは、性能を測る共通のテストであるベンチマークです。採用、医療、融資、教育、住宅、刑事司法など29分野の300シナリオを収録しています。各シナリオでは2候補から選び、優劣が明確な場合と、判断が難しい場合を用意しています。
属性情報は、示さない場合、名前で示唆する場合、間接的に示す場合、明示する場合の4条件です。さらに、権威や社会的合意などを持ち出す説得文を両候補について用意し、同じ種類の説得でも属性によって影響が変わるかを測ります。
組み合わせたテストケースは1300万件超です。軽量版のFairStress-Coreは5万項目で構成されます。ダウンロード可能で、評価基盤Olmo-evalへの組み込みも進めています。日本での提供は発表には書かれていません。