OpenAIは2026年10月5日(米国時間)、EUのAI法が求める「AIが作った文章を機械で見分けられるようにする」決まりへの対応を発表しました。ChatGPTとCodexの文章に、読む人には見えない電子透かしを入れます。
EUのAI法は、AIが作ったものに機械で読める印を求める
AI法の第50条は、文章や画像などを作るAIの提供者に、出力へ機械で読める印を付け、AIが作ったと見分けられるようにすることを求めています。欧州委員会によると、この決まりは2026年8月2日から適用が始まりました。
守り方の目安として、欧州委員会は行動規範(守り方の手引き)を用意しています。OpenAIのヘルプによると、OpenAIも署名しています。
ChatGPTはEUだけ、APIは世界で選べる
| 対象 |
内容 |
時期 |
| ChatGPT・Codex |
EUの対象の文章に透かし(全プラン) |
今後数週間で |
| API |
一部のモデルで、利用者が透かしを有効にできる(初めはオフ) |
10月5日から |
| 見つける道具 |
認められた研究者・専門機関から申し込みを受ける |
10月5日から |
We are not making text watermarking a global default at launch.
出典: OpenAI「Our approach to EU text provenance rules」
(当社訳)開始の時点では、文章の透かしを世界共通の初期設定にはしません。
透かしの技術「textGrain」は、モデルの言葉の選び方に統計の印を入れる仕組みです。ヘルプによると、隠れた文字や見えない空白は加えないため、コピーして貼っても余計なものは入りません。
短い文章と書き換えには弱い
誤って「透かしあり」とする割合を1%にした条件で、200トークン(言葉の単位)の文章では約80%、400トークンでは約95%で透かしが見つかりました。数学のように言い回しの幅が小さい内容では、割合が大きく下がります。
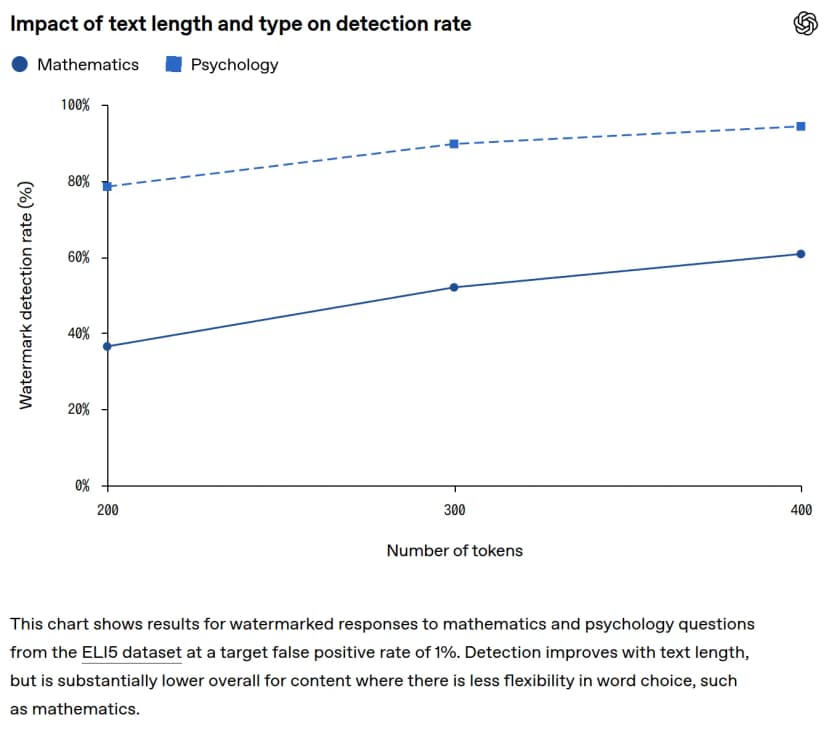 OpenAIの発表にある、文章の長さと内容で透かしの見つかる割合が変わるグラフ出典: OpenAI「Our approach to EU text provenance rules」(引用)
400トークンの文章で単語の10%を言い換えると、見つかる割合は約92%から66%に、25%では17%に下がりました。ヘルプによると、行動規範は200トークン(英語で約150語)より短い出力とコードには透かしを求めていません。
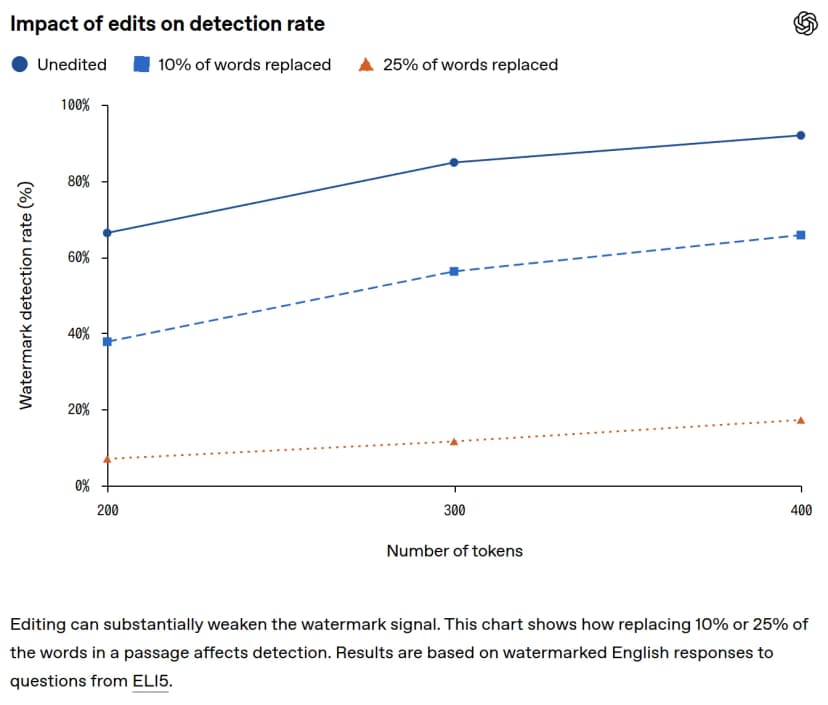 OpenAIの発表にある、単語の言い換えで透かしが見つかりにくくなるグラフ出典: OpenAI「Our approach to EU text provenance rules」(引用)
日本の利用者と日本の会社への関わり
日本での提供の状況を、公式に書かれている範囲でまとめます。
- ChatGPT・Codex: 透かしを入れるのはEUだけです。日本の名前は発表にもヘルプにもありません。EUの利用者かどうかを、住んでいる国と今いる場所のどちらで決めるのかも書かれていません。
- API: 世界のAPI利用者が有効にできるとしており、日本の会社も選べます。組織の設定の「Data controls」か、プロジェクトの設定にある「Text provenance」で、モデルごとにオンにします。
- EU向けにサービスを出す会社: AI法の第2条は、EUの外にある提供者でも、EUでAIシステムを市場に出す場合や、出力がEUで使われる場合に適用すると定めています。自社に追加の表示が要るかについて、OpenAIは助言できないとし、法務で確かめるよう案内しています。
暮らしと仕事への影響
OpenAIは、透かしが見つかっても、人がどれだけ手を加えたか、だれが書いたか、内容が正しいかは分からないと説明しています。見つからないことも、人が書いた証拠にはなりません。
日本のAIのルールは、国のAIのルールは暮らしと仕事にどう関わる? AI法と基本計画の要点にまとめています。
関西の暮らしと仕事での使いどころ
たとえば、欧州からの観光客向けの案内文や、欧州の取引先へのメールをAPIで作る仕組みを持つ会社なら、どのモデルで透かしを入れるかを設定で決めておく使い方ができます。
学校や職場で「AIが書いたかどうか」を話し合うときは、透かしが書いた人や中身の正しさを示すものではない点を、先に共有しておくと行き違いを防げます。欧州向けの仕事がある会社は、早めに法務と話しといてな。